
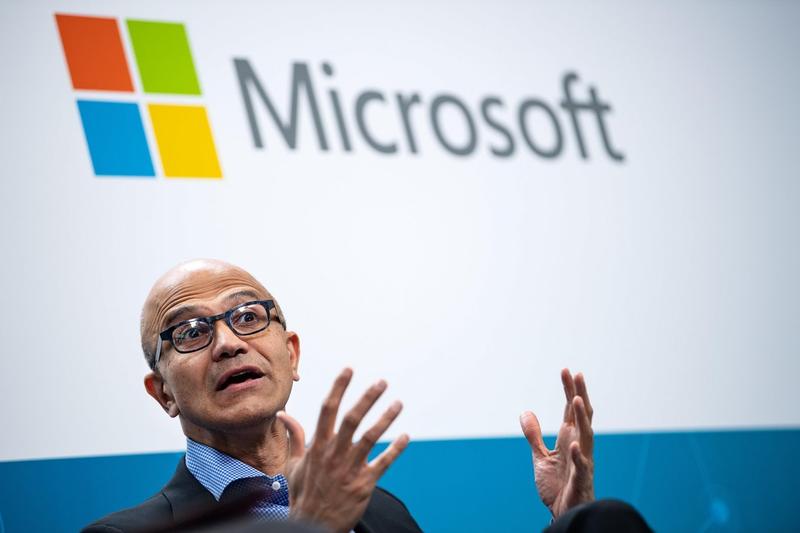
Conform HotNews: Satya Nadella, CEO Microsoft, atrage atenția asupra riscurilor ascunse în utilizarea modelelor AI
O îngrijorare tot mai pronunțată în rândul specialiștilor din Silicon Valley vizează modul în care marile laboratoare de inteligență artificială ar putea folosi datele clienților lor. Pe măsură ce companiile și startup-urile integrează modele AI dezvoltate de entități precum OpenAI și Anthropic, acestea dezvăluie informații critice despre propriile operațiuni. Există temerea că aceste informații ar putea fi utilizate de dezvoltatorii modelelor pentru a concura pe piața clienților lor.
Companiile „plătesc dublu” pentru accesul la inteligența artificială
Satya Nadella, directorul general al Microsoft, a subliniat într-o postare pe blogul său că utilizatorii modelelor AI „plătesc un preț dublu”. Pe lângă costul direct al utilizării, prin plata tokenurilor AI necesare pentru funcționare, companiile cedează, adesea inconștient, date valoroase. Cu cât un model AI este mai performant și mai bine adaptat nevoilor utilizatorului, cu atât acestuia trebuie furnizate mai multe informații specifice.
Nadella explică faptul că aceste modele „învață din reziduuri”: din instrucțiunile (prompt-urile) introduse de utilizatori, din interacțiunile cu agenții AI și, în special, din corecturile operate atunci când modelul generează erori. Această „distilare” a informațiilor generează un „know-how” instituțional greu de obținut prin alte mijloace. Acesta este, conform lui Nadella, „genul de cunoaștere pe care un concurent nu ar putea niciodată să o cumpere”.
Dreptul la „distilare” vs. protecția datelor
CEO-ul Microsoft ridică problema dublului standard în practica inteligenței artificiale. Dacă furnizorii de modele AI au libertatea de a accesa și utiliza date de pe internet pentru a-și antrena algoritmii, atunci și companiile ar trebui să aibă dreptul de a studia sau „distila” acele modele. Spre exemplu, în luna februarie a acestui an, Anthropic a acuzat companii chineze de utilizarea a milioane de solicitări către modelul său Claude pentru a-și îmbunătăți propriile sisteme.
Nadella consideră ipocrită situația în care dezvoltatorii își antrenează modelele cu date publice, dar le interzic altora să analizeze sau să reproducă funcționalitatea acestora. El menționează că, deși este necesar ca furnizorii de modele să beneficieze de „fair use” pentru antrenarea pe date publice, impunerea unor restricții asupra „distilării” este problematică, mai ales în contextul în care Microsoft este un investitor major în OpenAI.
O soluție centrată pe „orchestrare” și proprietatea datelor
Îngrijorarea principală a lui Nadella vizează scenariile în care dezvoltatorii de modele AI își rezervă dreptul de a învăța din datele colectate despre utilizarea și interacțiunile clienților.
Soluția propusă de șeful Microsoft implică un instrumentar de control pentru companii. El recomandă companiilor să își păstreze proprietatea asupra datelor lor, incluzând instrucțiunile transmise, feedback-ul oferit și alte informații aferente. De asemenea, Nadella sugerează implementarea unor „straturi de orchestrare”. Aceste mecanisme ar permite companiilor să comute cu ușurință între diferite modele AI oferite de furnizori variați, evitând astfel dependența de un singur prestator. Declarația sa subliniază că, atunci când se consumă inteligență artificială, se creează o formă de inteligență proprie, iar aceasta ar trebui să aparțină utilizatorului.
Sursa: HotNews
